4.1 Prestazioni
Il datapath SINGLE è valutato in simulazione RTL con periodo di 4 ns. Throughput e tempo di risposta AllReduce usano due rank su porte separate; la latenza dell'ultimo contributo usa otto rank su una porta full-duplex. Le prime quattro sezioni usano il core a due porte con entrambi i percorsi aritmetici; l'ultima sezione ripete le misure di velocità sul profilo U280 rilasciato, a una porta.
Throughput DATA
Con 4096 elementi per rank e accumulo Kulisch, INT8 raggiunge 13,65 miliardi di elementi/s per porta, rispetto ai 3,26 miliardi di FP32. A velocità simili in bit numerici, il numero di elementi cambia perché ogni beat contiene più valori nei formati più stretti.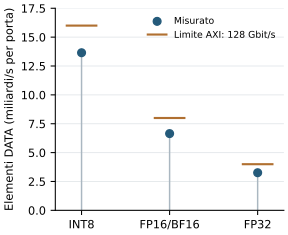
Throughput RESULT
Con gli stessi ingressi FP32, il throughput aggregato dei frame raggiunge 110,5 Gbit/s con AUTO, 121,5 Gbit/s con uscita FP32 e 124,3 Gbit/s con uscita Kulisch. La composizione dei pacchetti e la selezione del formato contribuiscono alla differenza. Per valutare il traffico necessario a una collettiva occorre anche considerare i byte totali, confrontati nella pagina Traffico.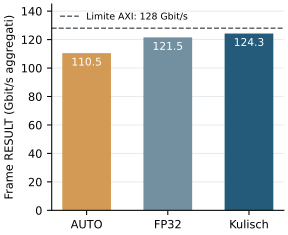
Tempo di risposta AllReduce
Il tempo di risposta include la configurazione e va dalla prima trasmissione STAGE all'ultimo beat RESULT accettato dall'ultima destinazione. La configurazione richiede 141 cicli. Con Kulisch il tempo totale passa da 196 cicli per 64 elementi a 673 per 4096; FP32_ARRIVAL richiede rispettivamente 203 e 683 cicli. Per 4096 elementi corrispondono a 2,69 µs e 2,73 µs, con il periodo assunto di 4 ns.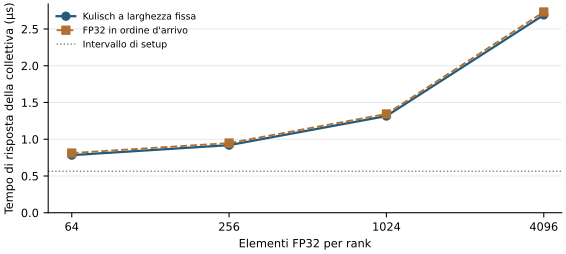
Latenza dell'ultimo contributo
In questo caso i primi sette contributi sono già presenti. L'intervallo misurato parte dall'ultimo beat DATA accettato dell'ottavo contributo e termina al primo beat RESULT accettato in uscita.
Con ingressi FP32, Kulisch richiede 152 ns per 64 elementi e 200 ns per 256; FP32_ARRIVAL richiede 160 ns e 304 ns. L'accumulo Kulisch emette valori Kulisch, mentre l'accumulo FP32 emette valori FP32. Ripetendo il precaricamento con 128 e 256 cicli di attesa si ottengono le stesse latenze.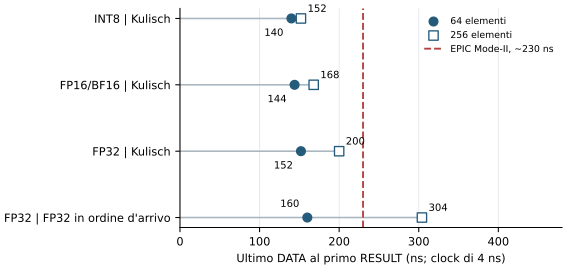
Lo studio FPGA di EPIC riporta quel riferimento per otto rank FP32 su Agilex. I dettagli mancanti e la diversa piattaforma permettono soltanto un confronto di contesto.
Velocità di linea del profilo U280
La build rilasciata ha una porta, Kulisch a 280 bit in quattro banchi esatti e nessun percorso FP32. Il suo requisito è almeno 100 Gbit/s su ogni ingresso e ogni uscita, misurati per flusso dal primo all'ultimo beat accettato. Il test usa due rank su una porta con 4096 elementi ciascuno, per tutte le 24 coppie di quattro formati di ingresso e sei politiche di uscita, e controlla ogni valore.
- Payload DATA: 103,70 Gbit/s con INT8, 102,08 con FP16/BF16 e 100,98 con FP32, che richiede più frame e paga circa quattro cicli di ammissione per frame.
- Payload RESULT: 122,27 Gbit/s per i risultati nativi e AUTO, 121,26 per Kulisch, qualunque sia il formato di ingresso.
- AUTO con pochi valori esatti tra risultati INT8, il caso più difficile in uscita: 103,97–126,18 Gbit/s di byte dei frame su otto tile. Il più lento, con valori esatti nelle lane 16, 32 e 63, è il tile peggiore trovato da una ricerca esaustiva sui tile con al più quattro valori esatti.
Un collegamento 100 GbE porta al massimo 98,4 Gbit/s di byte dei frame con frame da 1514 byte: in tutti i casi misurati il core è più veloce della sua porta. Le figure sono copiate dagli asset di valutazione della tesi. Il throughput usa le misure Kulisch in 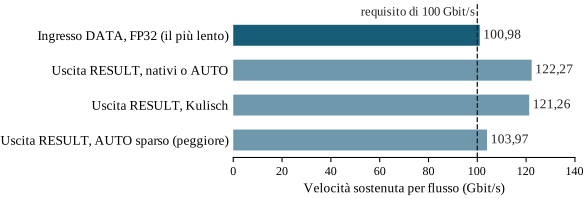
Sorgenti delle misure
experiments/02-experiment-numbergroup-single/results/evaluation-cycle-exact.csv. Le figure di risposta e latenza usano le misure sul percorso in ordine d'arrivo sotto build/experiments/fp32-arrival-online/; le sorgenti della latenza sono registrate nell'asset della tesi final_contribution_latency_8rank_sources.json. Le velocità del profilo U280 provengono dalla regressione del commit 812a183, suite rtl-u280-profile e rtl-result-wide-target; valori e script dei grafici sono in experiments/05-experiment-u280-release/.
Le prestazioni sulla scheda e le collettive più lunghe o multi-switch richiedono ulteriori misure.